Comment un grand modèle de langage écrit-il une phrase, morceau par morceau ?
Un chatbot ne planifie jamais toute sa réponse : il devine encore et encore le petit bout de texte suivant, puis le suivant.
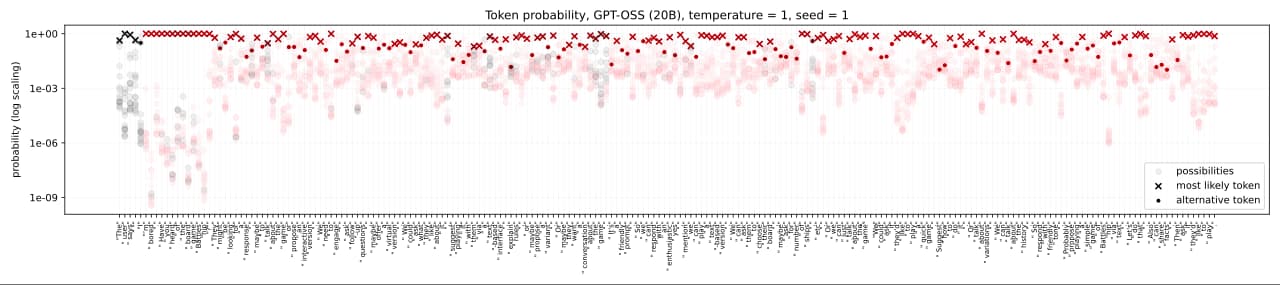
▶ Lancer l'histoireEn devinant le morceau suivant, encore et encore. Un grand modèle de langage est un réseau de neurones entraîné sur une immense quantité de texte, et au fond il ne fait qu'une chose : à partir du texte déjà écrit, il estime la probabilité de chaque morceau suivant possible. « J'aime manger » a-t-il plus de chances d'être suivi de « du pain » ou « des cailloux » ? Il choisit un morceau, l'ajoute au texte, et se repose la même question. Une réponse entière, c'est juste cette boucle, répétée encore et encore.
Ces morceaux s'appellent des tokens. Comme le modèle ne manipule que des nombres, le texte est d'abord découpé en tokens tirés d'un vocabulaire fixe, souvent des mots entiers ou des bouts de mots, et chacun devient un nombre, puis une liste de nombres appelée plongement (embedding).
Le plus astucieux, c'est la façon dont le modèle utilise le contexte. Son architecture, le transformeur, possède un mécanisme d'attention qui relie chaque token à tous les autres en même temps, aussi éloignés soient-ils : la fin d'une longue phrase peut donc dépendre de son début. À la fin, le modèle transforme son calcul en une probabilité pour chaque token de son vocabulaire. Un réglage appelé température décide de l'audace du choix : basse, c'est presque toujours le premier choix ; haute, il y a plus de hasard.
Cela explique une faiblesse célèbre. L'entraînement récompense une bonne estimation du mot suivant même quand le modèle manque d'informations : il peut donc produire un texte fluide, assuré, et faux. Quand la data scientist Teresa Kubacka a interrogé ChatGPT sur un phénomène qu'elle avait inventé, il a répondu avec des références d'apparence crédible.
Étape 1: Découper en tokens
Le texte devient des morceaux numérotés tirés d'un vocabulaire fixe.
Étape 2: Plonger
Chaque token devient une liste de nombres.
Étape 3: Faire attention
L'attention relie chaque token à tous les autres dans la fenêtre.
Étape 4: Noter chaque token suivant
Le modèle donne une probabilité à chaque token du vocabulaire.
Étape 5: Choisir, ajouter, recommencer
On choisit un token, la température réglant l'audace, et la boucle repart.
Quiz
0/3
Récap
Des tokens en entrée, des probabilités en sortie : on en choisit un, on l'ajoute, on recommence.
Le fait surprenant · Un modèle a inventé une réponse plausible, références à l'appui, sur un phénomène physique qu'une data scientist venait d'inventer.
Liens
- 🤖 Pourquoi les chatbots d'IA inventent-ils avec assurance des faits et des procès ?
- 🧠 Comment un réseau de faux neurones apprend-il à reconnaître un chat ?
- 🤖 Qu'est-ce que ça prouverait, qu'une machine réussisse le test de Turing ?
- 🀄 Un ordinateur qui répond parfaitement en chinois en comprend-il un seul mot ?
- Transformer deep learning
Sources (5)
Pas de source, pas d'affirmation. Chacun des 26 faits de cette leçon renvoie à au moins une de ces sources.